
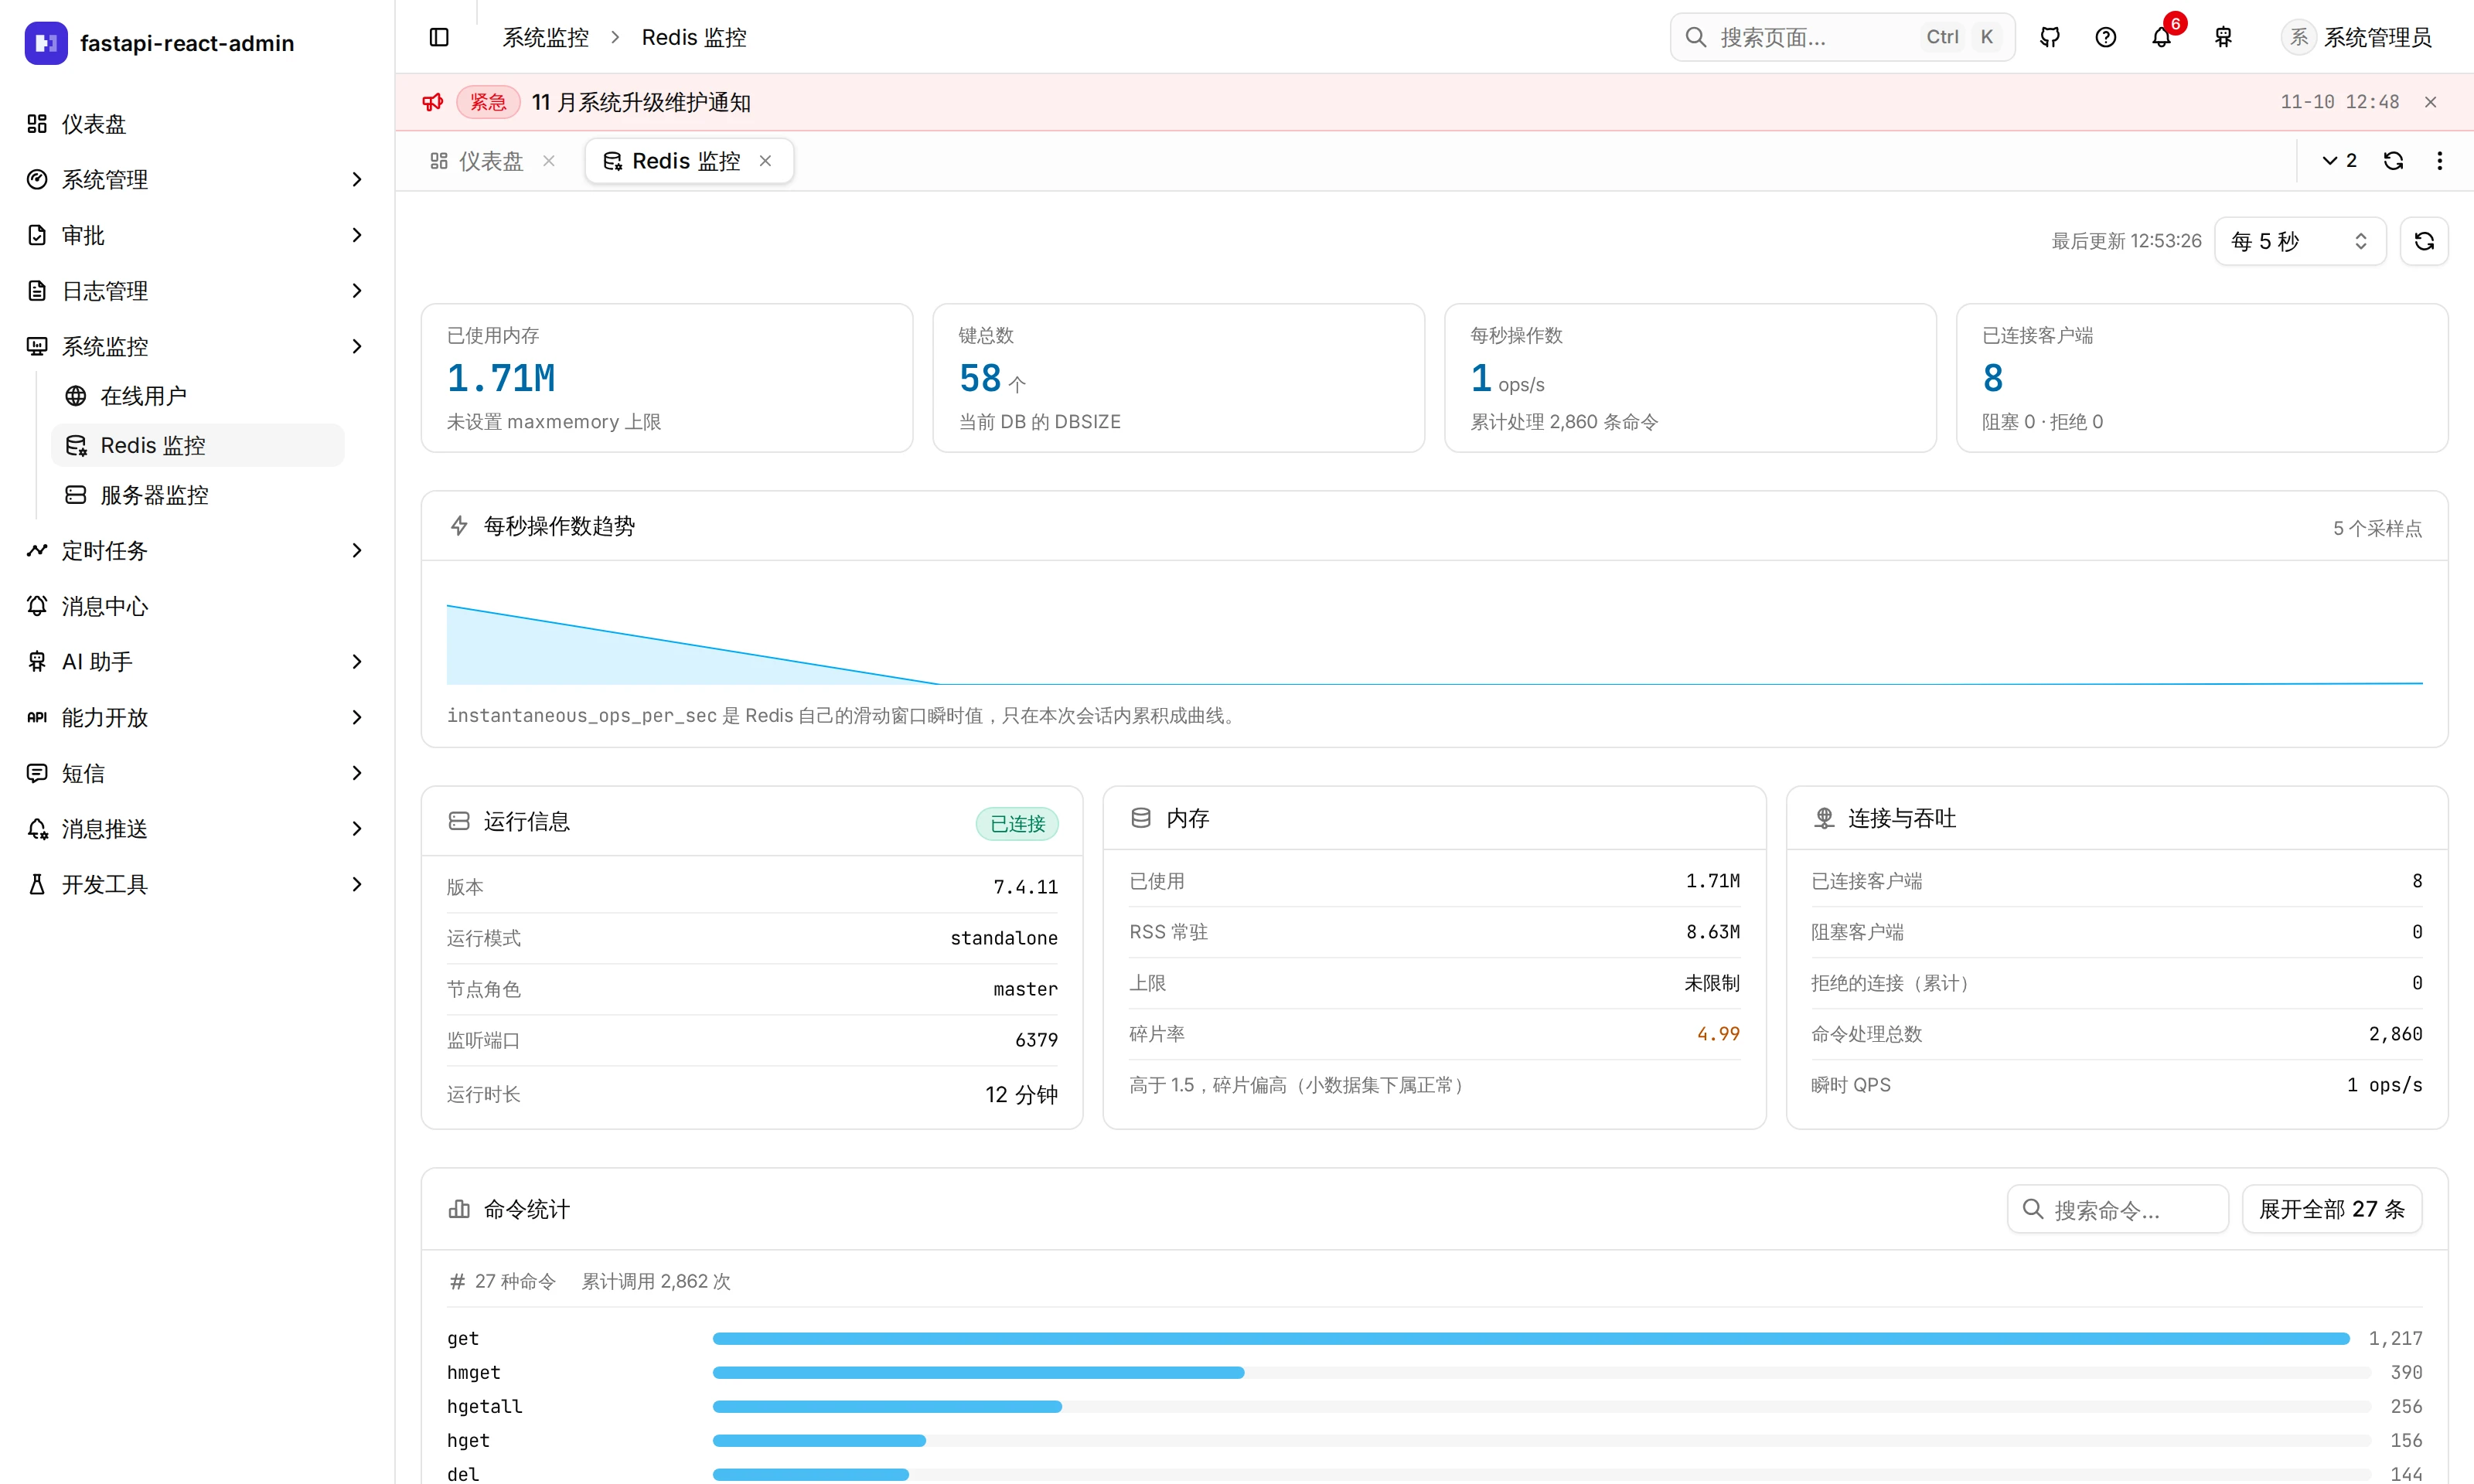
后台自带两个监控页:服务器监控看跑后端的那台机器此刻的 CPU、内存、磁盘和后端进程本身;Redis 监控看内存、键数、每秒操作数、客户端和最耗时的命令。两页都只显示此刻,趋势线只是这次打开页面以来的几十个采样点,不落库。给外部监控系统用的是另一个地址:/api/health/status,不用登录,一次列出 API、数据库、Redis、调度器(beat)和 worker 是否正常。
在界面上哪里找?
Section titled “在界面上哪里找?”| 入口 | 路径 | 谁能用 |
|---|---|---|
| 系统监控 → 服务器监控 | /monitor/server | 超级管理员 |
| 系统监控 → Redis 监控 | /monitor/redis | 超级管理员 |
| 系统监控 → 在线用户 | /monitor/online | 超级管理员,见登录会话 |
| 工作台「服务状态」卡片 | /dashboard | 超级管理员 |
| 健康检查 | /api/health/status | 不用登录 |
监控类页面和接口按超级管理员判,没有权限码:给普通角色授了这几个菜单也打不开。
两个监控页显示什么?
Section titled “两个监控页显示什么?”服务器监控:
- 顶部四个指标:CPU、内存、占用最高的那块磁盘、运行时长;CPU 和内存带趋势线
- CPU 核数与频率;内存总量 / 已用 / 空闲
- 系统:主机名、操作系统、架构、IP、分区数
- 后端进程:Python 版本、启动时间、CPU、常驻内存、虚拟内存、解释器路径
- 磁盘列表(
overlay、tmpfs这类虚拟文件系统不列)
Redis 监控:
- 已用内存与上限(
maxmemory)、内存碎片率(带解读提示) - 键数量 —— 只是当前库(
DBSIZE),同一台 Redis 上其他库的不算 - 每秒操作数和它的趋势
- 客户端:已连接、阻塞中、被拒绝(被拒绝是累计值)
- 版本、模式、角色、端口(容器里看到的端口)
- 命令统计:调用最多的前 10 条,可搜索
刷新:手动,或每 5 / 10 / 30 / 60 秒,默认 10 秒,选择写进地址栏(?refresh=)。页签切到后台时停止轮询,切回来再继续。
趋势线最多保留 40 个点,关掉页面就没了 —— 这两页是「现在怎么样」,不是监控系统。要看历史曲线、要告警,接 Prometheus / Zabbix / 云监控这类专门的系统。
健康检查接口返回什么?
Section titled “健康检查接口返回什么?”GET /api/health/status,不用登录、不限流、不进操作日志。并发检查五项:
| 项 | 怎么判 |
|---|---|
api | 能响应就是正常 |
database | SELECT 1,5 秒超时 |
redis | PING,3 秒超时 |
scheduler | beat 的调度循环每一拍写一次心跳(至少每 60 秒一拍,写入最多每 15 秒一次) |
worker | beat 每 60 秒派一个 health.heartbeat 任务,worker 执行时写心跳 |
心跳超过 180 秒没更新记 stale,从没写过记 missing,Redis 读不了或调度器本身不正常时 worker 记 unknown(worker 的心跳是 beat 派发的,beat 不在就无从判断)。
全部正常返回 200,任何一项不正常返回 503,响应体里逐项列出状态和心跳的秒数。出错时只给异常的类型名,不带异常消息(免得把连接串之类的东西漏给匿名访问者)。后端整个挂了时,nginx 直接返回 503 和 {"status":"unavailable"},并带上 Retry-After: 15。
响应体最后还带 version(版本号)和 commit(7 位提交号),用来确认线上跑的是哪一版;它们不影响 200 / 503 的判定,提交号没有写进镜像时是 null。前端那一份在 /version.json 里,登录后点顶栏的「帮助 → 关于」可以并排看到前后端的版本,两端不一致会标出来。
外部监控该探哪个地址、为什么不能用 /healthz,在部署到服务器里。容器编排用的是另一个只查数据库和 Redis 的 /health/ready。
工作台的「服务状态」卡片读的是同一套检查,外加网页 / 桌面 / 移动三端各有多少在线会话;它不自动轮询,20 秒内重复打开用缓存。
有哪些开关?
Section titled “有哪些开关?”都在 .env,改完重启后端:
| 键 | 默认值 | 说明 |
|---|---|---|
HEARTBEAT_MAX_AGE_SECONDS | 180 | 心跳多久没更新就算不正常;默认等于 3 个周期,漏一两拍(重启、发版换容器)不报警 |
SCHEDULER_HEARTBEAT_REDIS_KEY · WORKER_HEARTBEAT_REDIS_KEY | fba:health:scheduler_heartbeat · fba:health:worker_heartbeat | 心跳写在 Redis 的哪个键 |
监控页的刷新间隔在页面上选,不需要配置。
- 服务器监控看的是跑后端 API 的那台机器(或容器),不是数据库、Redis 所在的机器。IP 是向外发一个 UDP 连接时用的本机地址,取不到就显示
127.0.0.1。 - 不存历史、不告警。
- beat 卡住但循环还在转时,调度器心跳仍可能在写,健康检查看不出来。
- 两个监控页没有后端测试和 E2E;健康检查有。
- 监控接口:
api/v1/monitor/server.py·redis.py - 健康检查:
core/registrar.py· 调度器心跳在app/task/utils/schedulers.py的tick· worker 心跳任务tasks/health/· nginx 的兜底apps/web/nginx.conf - 前端:
pages/monitor-server/·pages/monitor-redis/· 共用的刷新与趋势_shared/monitor.tsx· 工作台卡片dashboard/cards/services.tsx
security/test_health.py(23 条):不用 token、调度器挂了时 worker 记unknown、worker 初始化不会把连接绑在一次性的事件循环上,等等。- E2E 只覆盖工作台的「服务状态」卡片(五行状态 + 汇总,
dashboard-personalize.spec.ts)。
在演示站里试试
Section titled “在演示站里试试”在线演示(admin / 123456):打开「系统监控 → Redis 监控」,把刷新改成 5 秒,看每秒操作数的趋势线一点点长出来;换到别的页签再回来,中间没有采样。健康检查直接在浏览器里打开 https://fra.wubunan.com/api/health/status。