
导出在服务端做:列表页工具栏上点「导出」,按当前的筛选条件或勾选的那几行生成 xlsx / csv,数据范围和列表一样受约束。5000 行以内当场下载;更多的转成后台任务,做完发站内消息,文件在「个人中心 → 导出记录」里留 72 小时。导入走三步:下载带下拉选项的模板 → 上传后先预览(一行都不写,逐行告诉你哪里不对)→ 确认提交。用户、部门、字典项三处有导入,部门可以一份文件建出整棵树,上级写在下级后面也行。
在界面上哪里找?
Section titled “在界面上哪里找?”| 列表页 | 导出(权限码) | 导入(权限码) |
|---|---|---|
| 系统管理 → 用户管理 | sys:user:export | 有,只给超级管理员(不看权限码),只能新增 |
| 系统管理 → 部门管理 | sys:dept:export | sys:dept:import,三种模式都支持 |
| 系统管理 → 数据字典(选中一个字典类型后) | dict:data:export | dict:data:import,三种模式都支持 |
| 系统管理 → 通知公告 | sys:notice:export | —— |
| 日志管理 → 登录日志 / 操作日志 / 数据变更 | log:login:export · log:opera:export · log:change:export | —— |
| 个人中心 → 导出记录 | 登录即可,只看得到自己的 | —— |
种子数据里这些导入导出按钮没有授给任何非超管角色,要用的角色得在「角色管理」里勾上。业务数据的列表能勾选行、导出选中的;审计日志只读,只按筛选导出;树形列表没有多选。
导出能选什么?出来的文件长什么样?
Section titled “导出能选什么?出来的文件长什么样?”「导出」按钮是一个菜单,两项:
- 导出当前筛选结果(N 条):把列表上的筛选条件原样发给后端。后端不认识的筛选项直接拒绝,不会悄悄忽略、导出一份比你看到的更多的数据。
- 只导出选中的 N 条:勾了行才出现,一次最多 1000 条。
格式选 xlsx(默认)或 csv。文件名是 资源名_年月日-时分秒.xlsx。
- 列:导出资源定义好的全部列。后端支持按指定的列和顺序导出,但界面目前没有传这个参数。
- 时间:换算成导出人自己设的时区(个人中心里设,没设就用系统默认),格式
yyyy-mm-dd hh:mm:ss。 - xlsx 多一个「导出信息」工作表:谁导的、什么时候、用了哪些筛选条件、多少行、按哪个时区。csv 没有,用 UTF-8 带 BOM、CRLF 换行,Excel 直接双击打开不乱码。
- 行按 ID 倒序(最新的在前),部门按树的顺序。
- 超过 2^53−1 的整数(雪花 ID)写成文本,否则 Excel 会把最后几位变成 0。
数据量大了会怎样?
Section titled “数据量大了会怎样?”| 行数 | 行为 |
|---|---|
| 0 | 拒绝,提示没有可导出的数据 |
| ≤ 5000 | 在这次请求里生成,浏览器直接下载 |
| 5001 – 200000 | 转成 Celery 后台任务,按钮提示去「导出记录」看;做完发一条站内消息,点进去就是下载 |
| > 200000(部门是 20000) | 拒绝,不截断 —— 截断了的文件看起来和完整的一样 |
每个人同时最多 3 个排队或进行中的导出。后台任务开始执行前会再查一次权限:排队期间被收回了导出权限,这个任务就不跑。
「个人中心 → 导出记录」只列自己的:排队中 / 进行中(带进度条,每 3 秒刷新)/ 完成 / 失败(带原因)/ 已过期。文件存在默认存储的私有区,72 小时后删除,记录保留 90 天。清理任务 maintenance.purge_expired_exports 每小时第 20 分跑一次,顺带把卡住超过半小时的导出记成失败。
什么是公式注入?怎么防的?
Section titled “什么是公式注入?怎么防的?”导出的单元格如果以 =、+、-、@ 开头,Excel 打开时会把它当公式执行 —— 用户名填成 =HYPERLINK(…) 的人,就能让导出这份表的管理员点开一个链接。判定时会先跳过开头的空格、全角空格、不换行空格等,全角的 = + - @ 和制表符、回车、换行、\0 也算。
- xlsx:所有文本单元格都按「文本」类型写入并打上「以文本显示」标记,值本身不改。这一条只在 openpyxl 读回的层面测过,还没有在真的 Excel 里验过。
- csv:看起来像公式的单元格前面加一个
'。
另外,XML 不允许的控制字符换成 �,超过 32767 字符的文本截断(这是 Excel 单元格的上限)。
导入的模板和预览是怎样的?
Section titled “导入的模板和预览是怎样的?”模板是一个 xlsx:第一个工作表只有表头,第二个工作表「说明」逐列写着是否必填、说明和可选值。有固定选项的列带下拉:状态这类枚举、导入人看得到的部门编码、角色编码、字典类型编码,每列最多 500 项。选项短的直接写在下拉里,长的或带逗号的放进一个隐藏的工作表。下拉是「警告」级别:填了列表外的值 Excel 只提示、不拦,最终以后端校验为准。
上传只收 .xlsx:文件不超过 5 MB、解压后不超过 100 MB、最多 1000 行数据。只读第一个工作表(不管你保存时停在哪一页)。表头按文字匹配,字段名、中文名、英文名都认;必填列缺了或者有两列同名,整个文件拒收;认不出来的列在预览里列出来、不导入。单元格是公式的直接报错(不会读成空值),完全空白的行跳过。
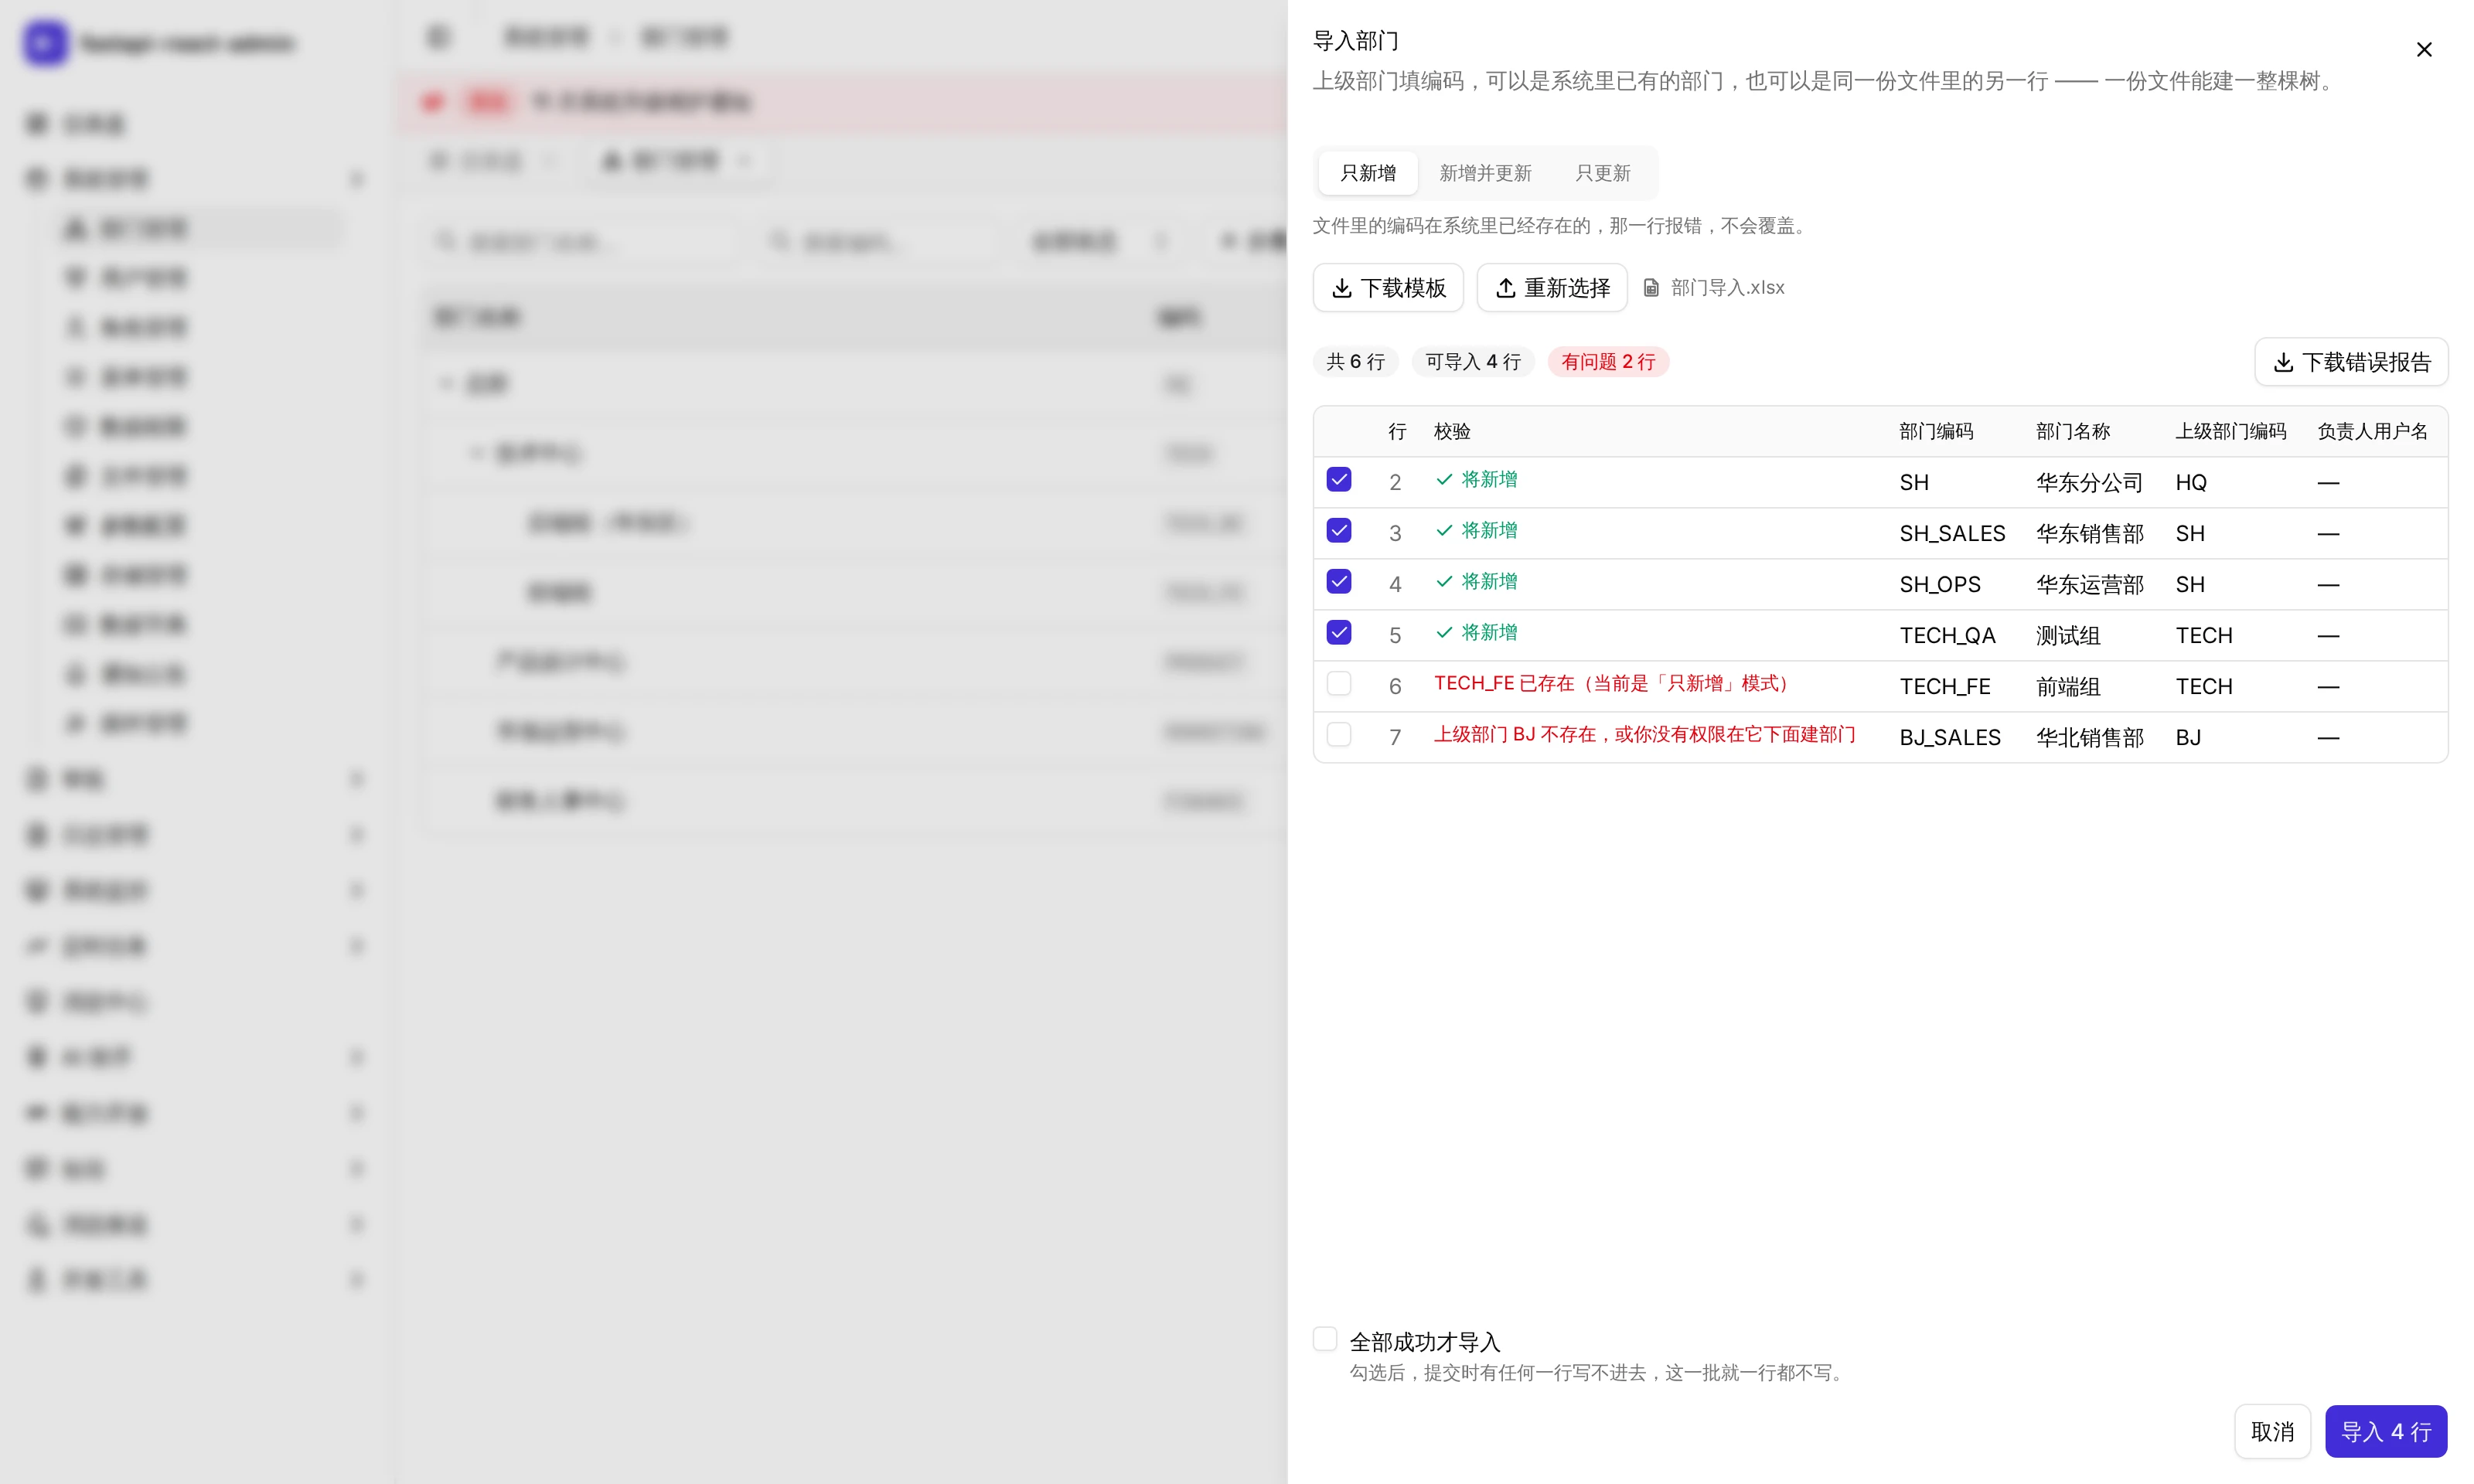
预览一行都不写,返回总行数、有效行数、将新增几行、将更新几行,以及每一行的问题。枚举列中英文和常见说法都认(「启用 / 禁用」「正常 / 停用」)。文件内部重复的行会标出「和第 N 行重复」。可以在预览里把某几行排除掉再提交;换导入模式会重新预览。
提交凭预览给的一次性令牌:30 分钟内有效,只能用一次,绑定了导入人和资源。提交时所有行会再校验一遍,因为预览之后库里的数据可能变了。
三种导入模式有什么区别?
Section titled “三种导入模式有什么区别?”| 模式 | 文件里的这条在系统里已经有了 | 没有 |
|---|---|---|
| 只新增 | 报错 | 新建 |
| 新增并更新 | 更新 | 新建 |
| 只更新 | 更新 | 报错 |
「已经有了」按什么判:部门看部门编码,字典项看字典类型编码 + 标签,用户看用户名(用户导入只能「只新增」,用户名、邮箱、手机号任何一个和已有用户撞了都算错)。更新时留空的单元格保留原值,不会把字段清空。
默认是能导的行先导进去、有问题的行跳过。勾上「全部成功才导入」之后,只要有一行失败,整批回滚、一行都不写。
有失败的行时可以下载错误报告:原表的内容加上「行号」「原因」两列,改好之后直接重新导入。报告只有导入人自己能下载,有效期和预览令牌一样。
一份文件怎么建出整棵部门树?
Section titled “一份文件怎么建出整棵部门树?”每行填自己的部门编码和上级部门编码(parent_code)。上级可以是系统里已有、并且导入人看得到的部门,也可以是同一个文件里的另一行,前后顺序随意 —— 提交时按层级从上往下写。环检测按「导入之后的树」算:同一个文件里把 A 挪到 B 下、B 挪出 A,不会被误判成环;真的成环会指出来。上级那一行本身有错时,挂在它下面的行也会被标出来。
有哪些开关?
Section titled “有哪些开关?”导入导出没有放进「参数配置」页,全部在 .env 里,改完重启后端(worker 也要重启):
| 键 | 默认值 | 说明 |
|---|---|---|
EXPORT_SYNC_MAX_ROWS | 5000 | 不超过它就当场生成,超过转后台 |
EXPORT_MAX_ROWS | 200000 | 单次导出上限,超过拒绝 |
EXPORT_MAX_CONCURRENT_PER_USER | 3 | 每人同时排队 / 进行中的导出数 |
EXPORT_FILE_RETENTION_HOURS · EXPORT_RECORD_RETENTION_DAYS | 72 · 90 | 文件留几小时、记录留几天 |
EXPORT_BATCH_SIZE | 1000 | 后台导出每批读多少行 |
TABLE_IMPORT_SIZE_MAX · TABLE_IMPORT_UNCOMPRESSED_MAX | 5 MB · 100 MB | 上传大小、解压后大小(防 zip 炸弹) |
TABLE_IMPORT_MAX_ROWS · TABLE_IMPORT_MAX_ENTRIES | 1000 · 1000 | 数据行数、压缩包内的条目数 |
IMPORT_EXPIRE_SECONDS | 1800 | 预览令牌和错误报告的有效期 |
USER_IMPORT_DEFAULT_PASSWORD | 空 | 导入的用户的初始密码。留空 = 用户导入关闭;要满足密码规则,生产环境拒绝弱默认值。刻意不放进参数配置页 |
定义在 core/conf.py 的导入、导出两段。
给自己的列表页加导入导出
Section titled “给自己的列表页加导入导出”导出:
- 在
app/admin/dataio.py(或插件自己的dataio.py)里register_export(ExportSpec(...)):资源名、权限码、列、可用的筛选项、取数的查询。查询要复用列表接口那个 DAO 的get_select—— 这样数据范围、筛选语义和列表一致,不会出现「列表看不到、导出能导出来」。 - 加一个
POST /xxx/export路由,挂RequestPermission('xxx:export'),调export_service.start(照dept.py抄)。 - 菜单按钮的权限码进三种数据库的种子 SQL、写一条数据迁移、更新
sql/seed_manifest.json——test_permission_codes.py会核对这几处对不对得上。 - 中英文案各加
export.*的键。 - 页面上
<Can perm><ExportButton path filters selectedIds total /></Can>。
Celery worker 通过 load_dataio_modules() 加载这些定义,所以插件里注册的资源也能后台导出。
导入:register_import(ImportSpec(...)) 声明列、匹配键(key_of)、校验、写入和支持的模式;加 /import/template、/import/preview、/import/commit 三个路由;页面上放 <ImportSheet>。逐步写法和踩过的坑在 common/dataio/AGENTS.md。
- 不导入
.xls和 csv;单元格里的公式不认。 - 导入时留空的单元格不能把字段清空;不能用导入把一个已有部门挪成顶级部门。
- 受数据范围限制的人导入新部门,建出来的部门可能落在他自己的范围之外、他看不到。
- 同一个文件里交换两个同级部门的名字会撞名。
- 用户导入只能新增、只给超级管理员,所以「导出来的用户表改完直接导回去」行不通;这条往返只对部门测过。
- 后台导出的「完成通知」依赖消息通知插件(
notification),没装就不发,只能去「导出记录」看。 - 界面上还不能挑选导出哪些列。
几处界面文案和实际行为有出入,记在这里免得照着文案理解错:
- 部门模板里
parent_code的说明是「留空是顶级部门」,但在「新增并更新 / 只更新」模式下,留空的意思是保留原来的上级。 - 导入弹窗里三种模式的说明写的是按「编码」匹配;字典项实际按「字典类型编码 + 标签」匹配(字典页自己的说明写对了)。
- 导出:
common/dataio/exporting.py(注册表)·export_service.py·common/dataio/cells.py(公式注入、单元格清洗)·writers.py· 后台任务tasks/export/tasks.py - 导入:
common/dataio/importing.py·import_service.py· xlsx 读写utils/excel_ops.py - 各资源的定义:
app/admin/dataio.py(用户、部门、日志)·plugin/dict/dataio.py - 前端:
pages/_shared/data-io/(导出按钮、导入抽屉)·profile/exports-panel.tsx
后端连真实的数据库:
test_export.py(24 条):超上限拒绝而不是截断、公式在 xlsx 里保持文本、在 csv 里加引号、后台导出只看得到自己的、worker 执行前重查权限、文件过期后先拒绝下载再被清理。test_import.py(29 条):一个文件里的树按层级先建上级、同一个文件里重组不误判成环、三种模式对已存在编码的不同处理、导出的文件原样导回来不变、写到一半失败时已写的行怎么办、提交时按数据库的最新状态决定新增还是更新。test_user_import.py(19 条):非超管三个接口全部拒绝、没配默认密码时导入关闭、同一个令牌不能提交两次。tests/test_excel_ops.py(37 条):只读第一个工作表、公式报错而不是读成空值、zip 炸弹在 openpyxl 打开之前就被挡住、长选项挪进隐藏工作表。
浏览器端(Playwright):data-io.spec.ts(导出的 CSV 就是当前筛选的那一批;导出记录里能再下载一次;一份文件建整棵部门树,下级写在上级前面也行)、user-import.spec.ts(预览分别指出三类问题、提交只建干净的行;同一个令牌不能提交两次;非 xlsx 文件被挡住并说明原因)。
在演示站里试试
Section titled “在演示站里试试”在线演示(admin / 123456):打开「系统管理 → 部门管理」,点「导入」下载模板,填两三行、其中一行的上级写成同一个文件里的另一行,上传后看预览怎么标出新增和问题。导出可以在「日志管理 → 登录日志」里试,按筛选导出一份 csv。演示站是共用的,导入的部门别人也看得到,试完请删掉。